Transcriptie
 Ondertitels (FCC/SDH)
 Transcriptbewerking & Proeflezen
 Vertaling (tekst/audio/afbeeldingen)
 Ondertitels
 Audiodescriptie (AD)
Diensten voor menselijke audio-annotatie & labeling


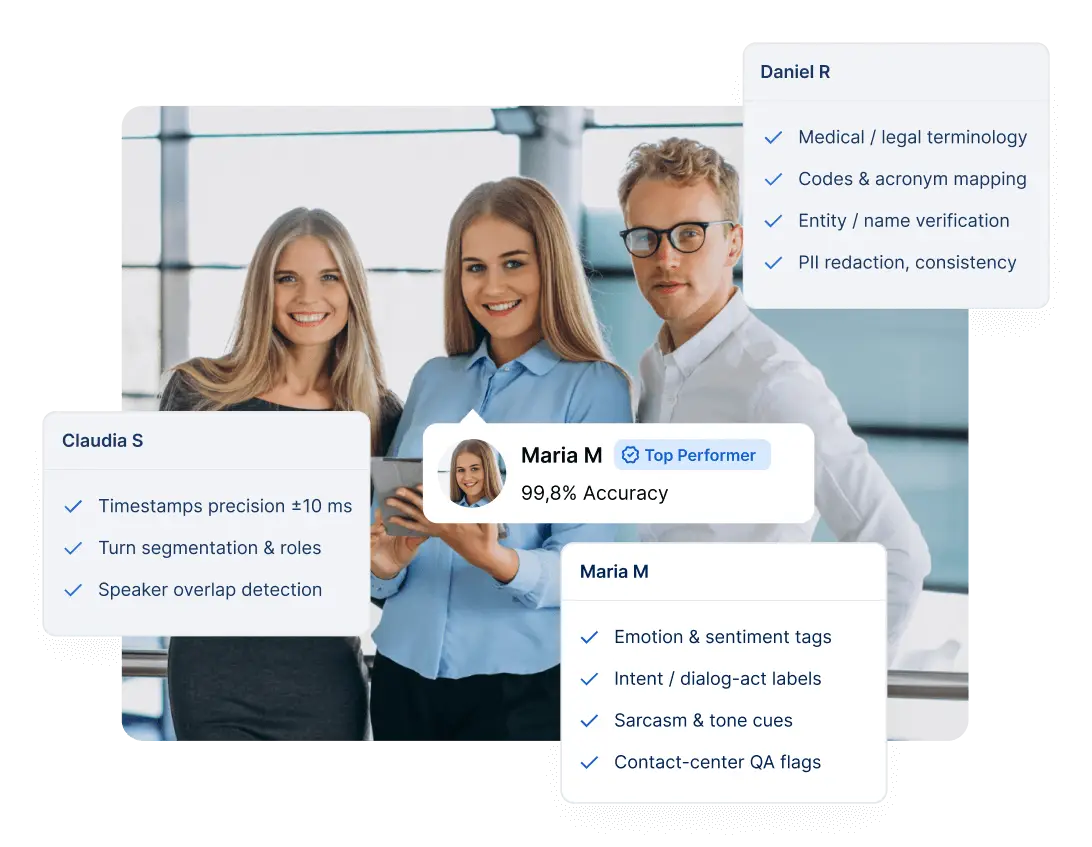
Diensten voor menselijke audio-annotatie & labeling
Human-in-the-Loop spraakdata-annotatie voor AI/ML
Versterk uw spraak-AI met door mensen gemaakte audiolabels: van transcriptie met tijdstempels (segment- en woordniveau) tot sprekerdiarisatie, sentiment- en emotieanalyse, intentieclassificatie, audiosegmentatie en non-verbale geluidsgebeurtenissen. Wij leveren in uw schema (JSON, JSONL, RTTM, CSV) met kwaliteitscontrole in meerdere stappen en beveiliging op bedrijfsniveau. Begin met een gratis proefproject en schaal op van proof of concept naar duizenden uren.
Human-in-the-loop labeling die uw schema weerspiegelt
Aangepaste audio-annotatie volgens uw richtlijnen
De menselijke audio-annotatiediensten van GoTranscript implementeren uw stijlgids, taxonomie en beslissingsregels exact: editors worden getraind in uw labeldefinities, voorbeelden, randgevallen en escalatiepaden.
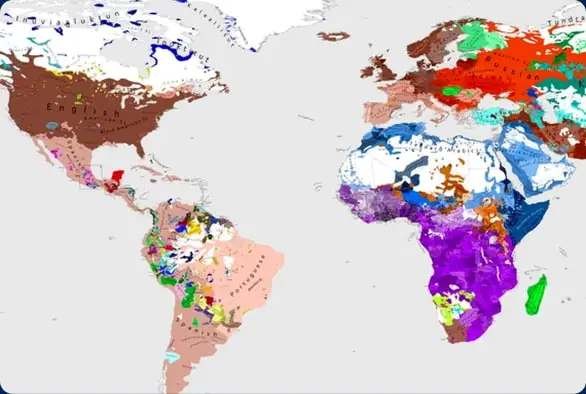
Meertalige audio-annotatie
140+ Talen
Schaal spraakdata-annotatie over meerdere talen en dialecten voor spraakassistenten, automotive spraak, eLearning, media en gebruiksscenario's voor contactcenters, met moedertaalsprekende editors en dialectnotities om foutpercentages te verlagen.
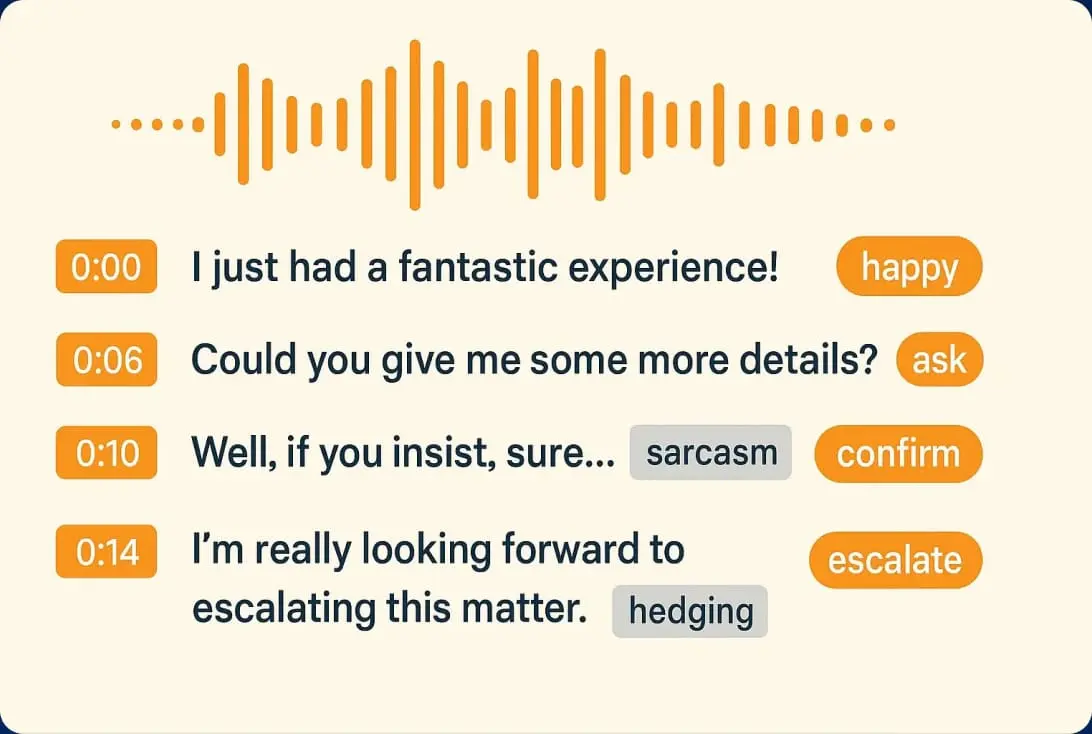
Annotatie van sentiment, emotie & intentie
Tags op uitingniveau voor conversationele AI
Verrijk transcripten met emotietags, sentiment per uiting, intentie/dialooghandelingen (vragen, bevestigen, escaleren) en nuances zoals sarcasme of ontwijking om NLU en de prestaties van spraakassistenten te verbeteren.
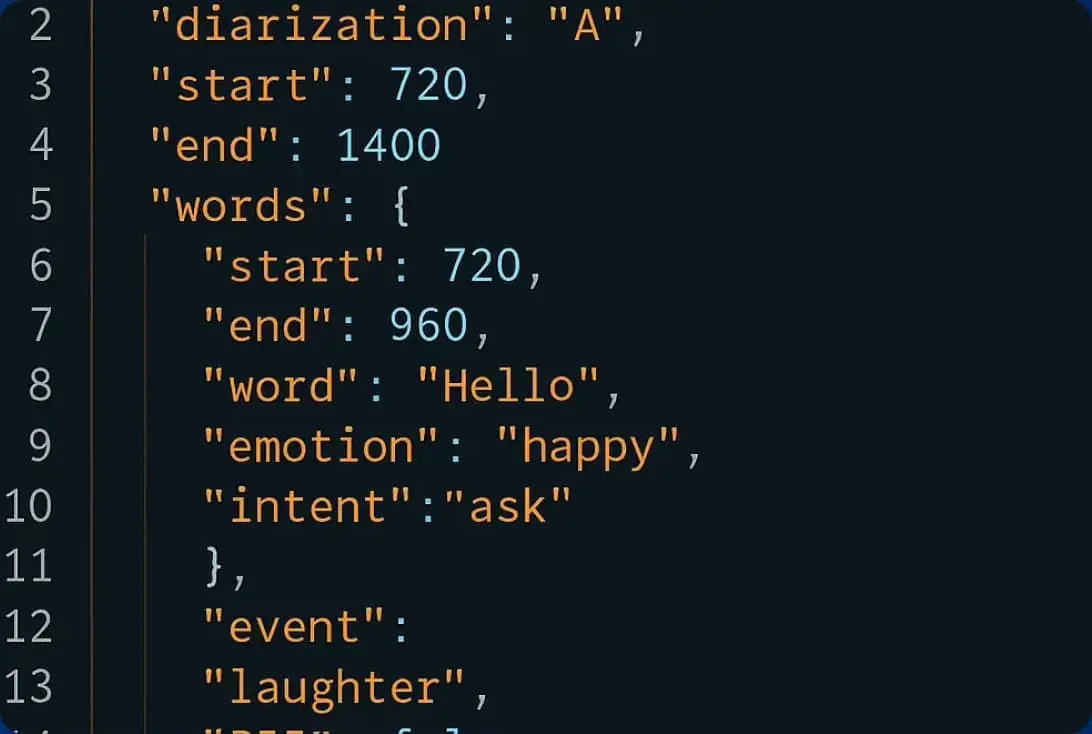
Aangepaste schema's, schone export
JSON, JSONL, RTTM of uw API-formaat
Wij passen ons aan uw labelontologie aan en leveren schema-conforme output (JSON/JSONL/RTTM/CSV) met duidelijke identificatoren, bereiken, tijdstempels en betrouwbaarheidsvelden. Klaar om te koppelen aan uw trainings-, evaluatie- of analysepijplijn
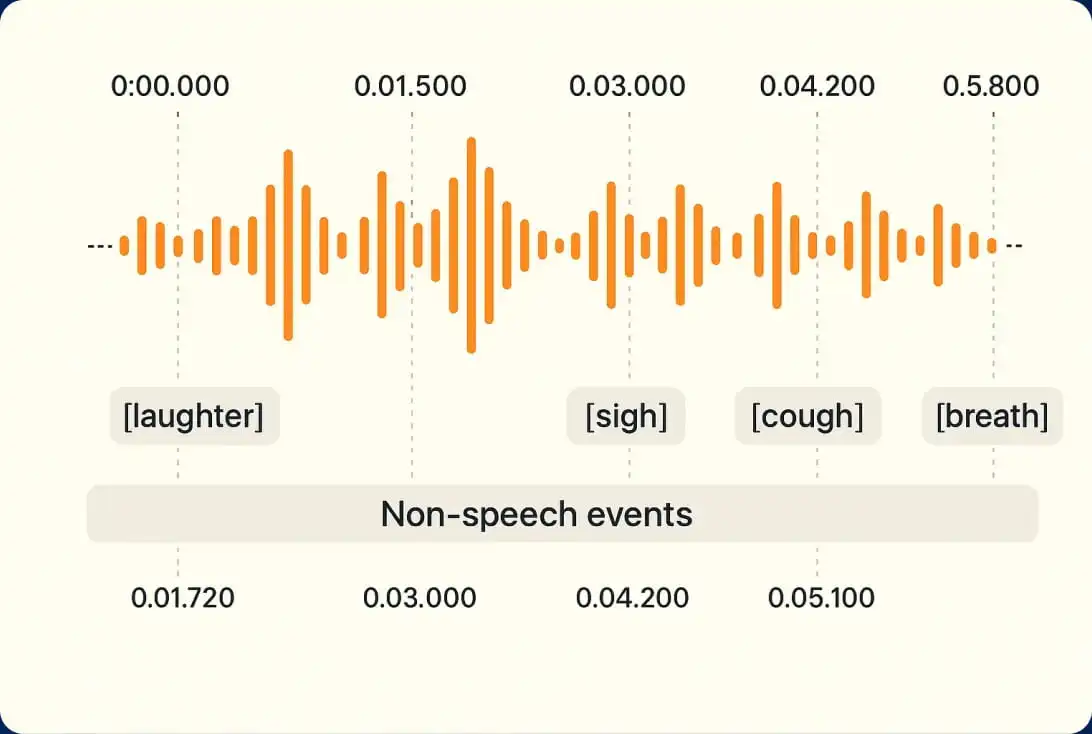
Detectie van geluidsgebeurtenissen & ruisclassificatie
Labeling van akoestische gebeurtenissen & non-verbale geluiden
Menselijke annotators markeren overlappingen/onderbrekingen, vulwoorden/haperingen, lachen/zuchten/hoesten, stiltes en achtergrondgeluiden voor betere audioclassificatie en robuuste ASR in echte omgevingen.
kwaliteitsmanagementsysteem
Menselijke kwaliteit voor transcriptie & audio-annotatie
Precisa is het kwaliteitsmanagementsysteem van GoTranscript dat zowel door mensen gemaakte transcriptie als menselijke audio-annotatie/labeling aanstuurt. Gebaseerd op toptalent, een tweestapsbeoordeling en transparante meting (WER voor transcripten; IAA/F1 voor labels), levert Precisa consistente en auditklare resultaten voor ASR-trainingsdata, sprekerdiarisatie, intentie- en emotielabeling en detectie van geluidsgebeurtenissen, op grote schaal.
Kunt u niet precies vinden wat u zoekt?
Altijd bereid om aan te passen
Wij stemmen de workflow af op uw briefing. Aangepaste schema's, labels en beoordelingsstappen, en we itereren snel via een proefproject tot het perfect is. De levering komt overeen met uw JSON-formaat en metadata, met een toegewijde redactionele leider, duidelijke SLA's en beveiliging op bedrijfsniveau.
Maximaliseer uw impact met precisie
Gebruiksscenario's
Contactcenter-analyse & agentondersteuning
Menselijke labels markeren beurten van agent/klant, sentiment, intentie, escalatie, resultaten en compliance-zinnen. Diarisatie en tijdstempels trainen scoring, coachen agenten en stemmen LLM-spraakagenten af om AHT te verlagen en CSAT te verhogen.
Spraakassistenten & LLM-voicebots
Annoteer intenties, slots, dialooghandelingen, toon, haperingen en onderbrekingsgebeurtenissen in gesprekken met meerdere beurten. Door mensen geverifieerde labels verbeteren de NLU-nauwkeurigheid, antwoordselectie en vangrails voor zakelijke voicebots en assistent-ervaringen.
Vergaderintelligentie & verkoopgesprekken
Diariseer sprekers, segmenteer onderwerpen en label actiepunten, bezwaren en vervolgstappen. Schone output zorgt voor betrouwbare vergadernotities, CRM-updates en coachinginzichten voor verkoop, succes, werving en interne discussies.
Vertrouwen, veiligheid & moderatie voor audio
Menselijke beoordelaars taggen haat, intimidatie, zelfbeschadiging, seksuele inhoud en bedreigingen met ernst en context. Meertalige dekking traint veiligere realtime moderatie voor sociale audio, in-game voicechat en live streaming.
ASR-training, benchmarking & afstemming
Transcripten op woord- en segmentniveau met nauwkeurige tijdstempels, diarisatie en ruislabels creëren robuuste trainings- en evaluatiesets. Meet WER en DER per taal, accent en omgeving om de fijnafstemming van het model te sturen.
Spraak in de zorg & klinische documentatie
Menselijke experts transcriberen en labelen medische terminologie, symptomen, medicijnen, voorschriften en context. PHI-redactie en kwaliteitscontrole leveren HIPAA-klare datasets voor ambient klinische documentatie, dictaat en spraakgestuurde EPD-workflows.
Automotive & spraak in voertuigen
Annoteer commando's, wekwoorden, intenties en akoestische gebeurtenissen zoals sirenes, toeters en weggeluid. Meertalige diarisatie en tijdstempels helpen bij het afstemmen van embedded en offline spraakinterfaces in auto's, vrachtwagens en navigatiesystemen.
Media, podcasts & doorzoekbare archieven
Maak hoofdstukmarkeringen, sprekertags, profaniteitsvlaggen en onderwerpstags voor ontdekking, advertenties en compliance. Gestructureerde metadata en tijdstempels maken nauwkeurig zoeken, clips en aanbevelingen mogelijk in grote audiobibliotheken.


Klaar om samen te werken op schaal?
Voer projecten met een hoog volume en meerdere talen uit met human-in-the-loop, kwaliteitscontrole in meerdere stappen en auditklare output (JSON/JSONL/RTTM/CSV). Wij stemmen af op uw richtlijnen, integreren snel met een kalibratieronde en leveren onder duidelijke SLA's.