Transkribering
 Teksting (FCC/SDH)
 Redigering og korrektur av transkripsjon
 Oversettelse (tekst/lyd/bilder)
 Undertekster
 Videobeskrivelse (AD)
Tjenester for menneskelig lydannotering og merking


Tjenester for menneskelig lydannotering og merking
Human-in-the-Loop stemmedata-annotering for AI/ML
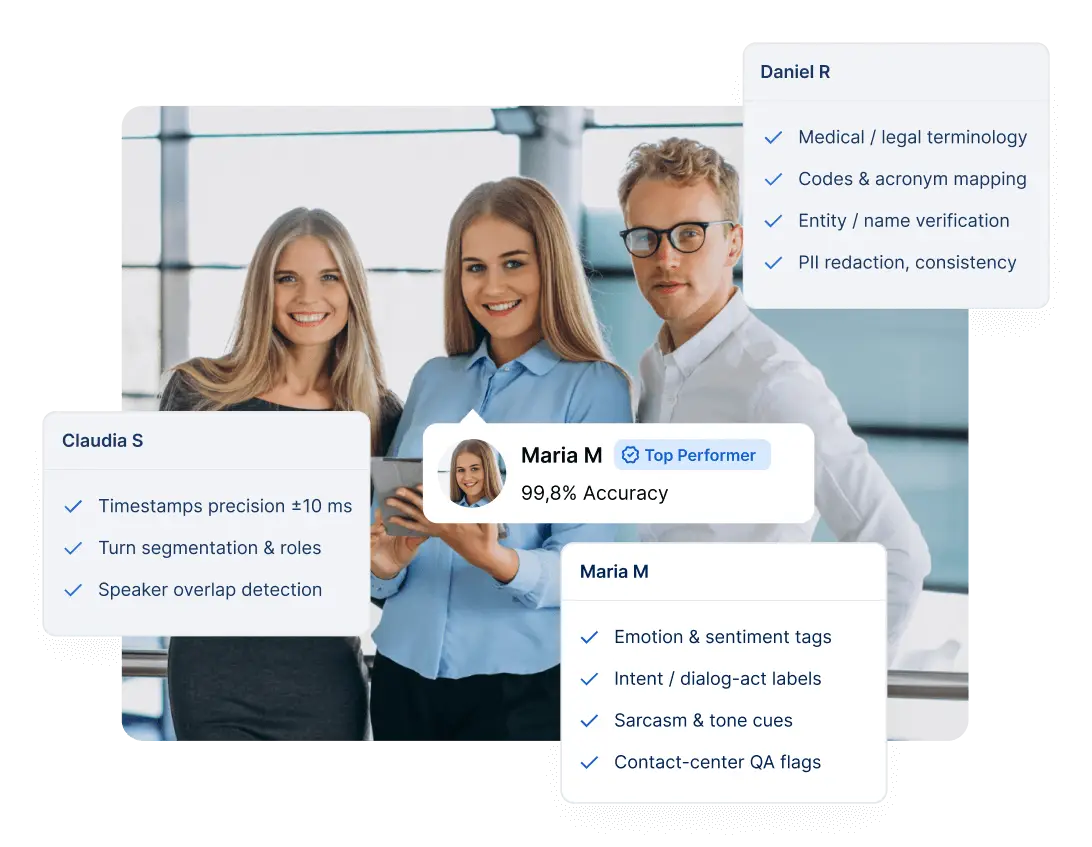
Styrk din stemme-AI med menneskeskapte lydetiketter: fra tidsstemplet transkripsjon (segment- og ordnivå) til talerdiarisering, analyse av sentiment og følelser, intensjonsklassifisering, lydsegmentering og ikke-verbale lydhendelser. Vi leverer i ditt skjema (JSON, JSONL, RTTM, CSV) med flertrinns kvalitetskontroll og sikkerhet på bedriftsnivå. Start med en gratis pilot og skaler fra proof of concept til tusenvis av timer.
Human-in-the-loop merking som gjenspeiler skjemaet ditt
Tilpasset lydannotering etter dine retningslinjer
GoTranscripts menneskelige lydannoteringstjenester implementerer din stilguide, taksonomi og beslutningsregler nøyaktig: vi trener redaktører i dine definisjoner av etiketter, eksempler, grensetilfeller og eskaleringsveier.
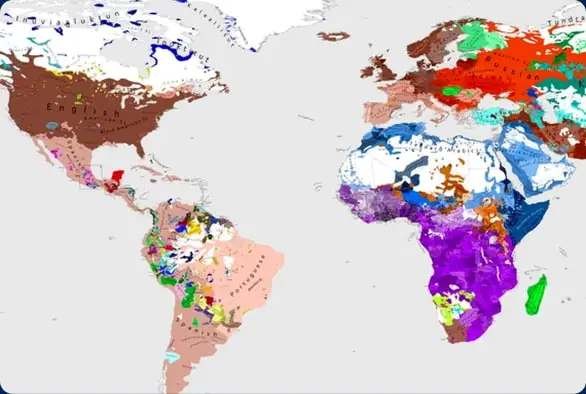
Flerspråklig lydannotering
140+ språk
Skaler annotering av taledata på tvers av språk og dialekter for taleassistenter, bilstemmestyring, eLearning, media og kundesenter-bruksområder, med morsmålsredaktører og dialektnotater for å redusere feilrater.
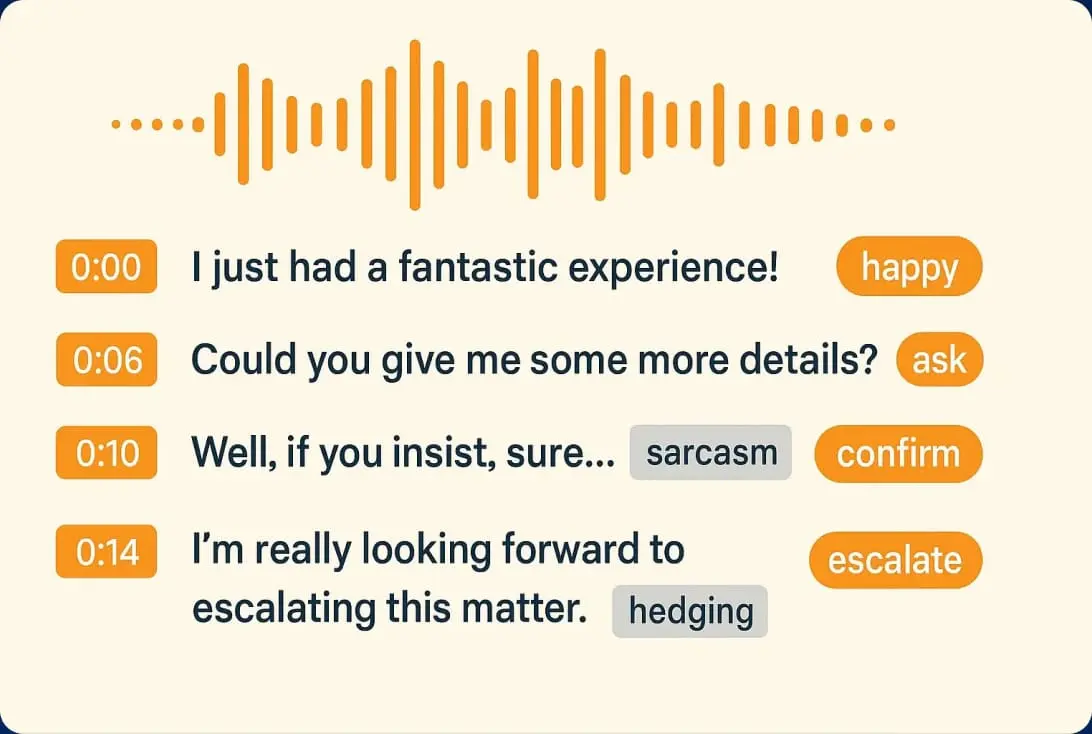
Annotering av sentiment, følelser og intensjon
Tagger på ytringsnivå for samtale-AI
Berik transkripsjoner med følelsesmerker, sentiment per ytring, intensjon/dialoghandlinger (spørre, bekrefte, eskalere) og nyanser som sarkasme eller unnvikelse for å forbedre NLU og taleassistentens ytelse.
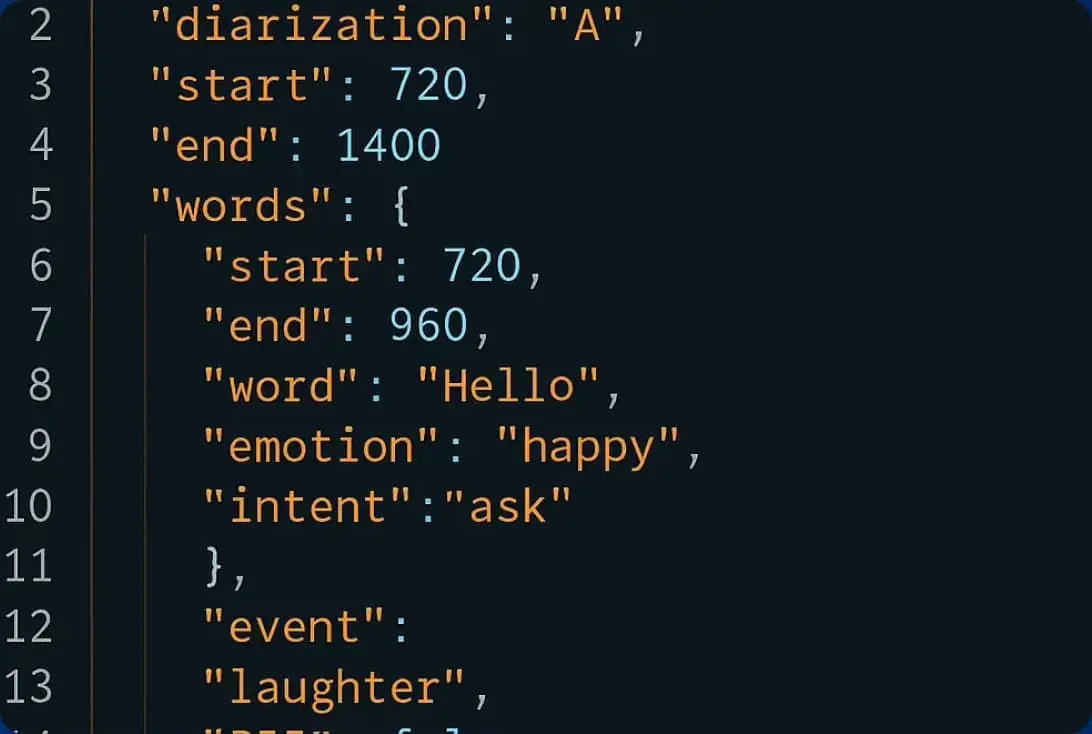
Tilpassede skjemaer, ren eksport
JSON, JSONL, RTTM eller ditt API-format
Vi tilpasser oss din etikettontologi og returnerer skjemakompatible utdata (JSON/JSONL/RTTM/CSV) med klare identifikatorer, områder, tidsstempler og konfidensfelt. Klar til å kobles til din trenings-, evaluerings- eller analysepipeline
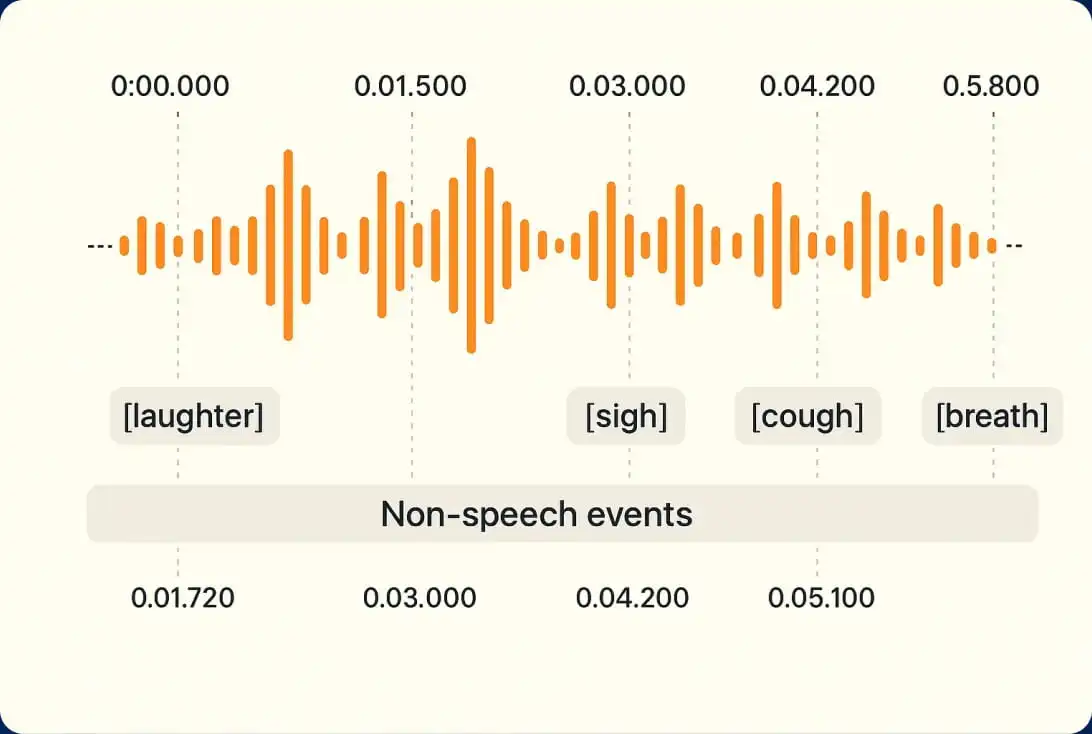
Deteksjon av lydhendelser og støyklassifisering
Merking av akustiske hendelser og ikke-verbal lyd
Menneskelige annotatører markerer overlappinger/avbrudd, fyllord/disfluenser, latter/sukk/hoste, stillhetspauser og bakgrunnsstøy for bedre lydklassifisering og robust ASR i virkelige miljøer.
kvalitetsstyringssystem
Menneskelig kvalitet for transkripsjon og lydannotering
Precisa er GoTranscripts kvalitetsstyringssystem som driver både menneskeskapt transkripsjon og menneskelig lydannotering/merking. Basert på elitetalenter, en totrinns gjennomgang og transparent måling (WER for transkripsjoner; IAA/F1 for etiketter), leverer Precisa konsistente og revisjonsklare resultater for ASR-treningsdata, talerdiarisering, intensjons- og følelsesmerking, samt deteksjon av lydhendelser, i stor skala.
Finner du ikke akkurat det du trenger?
Alltid klar til å tilpasse
Vi skreddersyr arbeidsflyten etter din brief. Tilpassede skjemaer, etiketter og gjennomgangstrinn, og vi itererer raskt gjennom en pilot til det er perfekt. Leveransen samsvarer med ditt JSON-format og metadata, med en dedikert redaksjonell leder, klare SLA-er og sikkerhet på bedriftsnivå.
Maksimer effekten din med presisjon
Bruksområder
Kundesenteranalyse og agentstøtte
Menneskelige etiketter markerer agent/kunde-turer, sentiment, intensjon, eskalering, utfall og samsvarsfraser. Diarisering og tidsstempler trener scoring, coacher agenter og finjusterer LLM-taleagenter for å redusere AHT og øke CSAT.
Taleassistenter og LLM-voicebots
Annoter intensjoner, slots, dialoghandlinger, tone, disfluenser og avbruddshendelser i samtaler med flere turer. Menneskeverifiserte etiketter forbedrer NLU-nøyaktighet, svarutvalg og sikkerhetsbarrierer for bedrifts-voicebots og assistenterfaringer.
Møteintelligens og salgssamtaler
Diariser talere, segmenter emner og merk handlingselementer, innvendinger og neste trinn. Rene utdata driver pålitelige møtenotater, CRM-oppdateringer og coachinginnsikt for salg, suksess, rekruttering og interne diskusjoner.
Tillit, sikkerhet og moderering for lyd
Menneskelige anmeldere tagger hat, trakassering, selvskading, seksuelt innhold og trusler med alvorlighetsgrad og kontekst. Flerspråklig dekning trener tryggere sanntidsmoderering for sosial lyd, stemmechat i spill og direktesendinger.
ASR-trening, benchmarking og tuning
Transkripsjoner på ord- og segmentnivå med presise tidsstempler, diarisering og støymerker skaper robuste trenings- og evalueringssett. Mål WER og DER etter språk, aksent og miljø for å veilede finjustering av modellen.
Stemme i helsevesenet og klinisk dokumentasjon
Menneskelige eksperter transkriberer og merker medisinsk terminologi, symptomer, medisiner, ordrer og kontekst. PHI-redigering og kvalitetskontroll leverer HIPAA-klare datasett for ambient klinisk dokumentasjon, diktering og stemmeaktiverte EPJ-arbeidsflyter.
Bil og stemme i kjøretøy
Annoter kommandoer, vekkeord, intensjoner og akustiske hendelser som sirener, horn og veistøy. Flerspråklig diarisering og tidsstempler bidrar til å finjustere innebygde og offline stemmegrensesnitt som brukes i biler, lastebiler og navigasjonssystemer.
Media, podcaster og søkbare arkiver
Lag kapittelmarkører, taleretiketter, profanitetsflagg og emneetiketter for oppdagelse, annonser og samsvar. Strukturerte metadata og tidsstempler muliggjør presist søk, klipp og anbefalinger i store lydbiblioteker.


Klar til å samarbeide i stor skala?
Kjør prosjekter med høyt volum og flere språk med human-in-the-loop, flertrinns QA og revisjonsklare utdata (JSON/JSONL/RTTM/CSV). Vi justerer oss etter retningslinjene dine, kommer raskt i gang med en kalibreringsrunde og leverer under klare SLA-er.